Article

SA-DSM-MADDPG for Multi-UAV Cooperative Encirclement in Obstacle-Rich Pursuit–Evasion Scenarios

School of Aeronautics and Astronautics, University of Electronic Science and Technology of China, Chengdu 611731, China
*
Author to whom correspondence should be addressed.
Drones 2026, 10(5), 360; https://doi.org/10.3390/drones10050360

Submission received: 26 March 2026 / Revised: 6 May 2026 / Accepted: 7 May 2026 / Published: 9 May 2026
(This article belongs to the Section Artificial Intelligence in Drones (AID))

Abstract

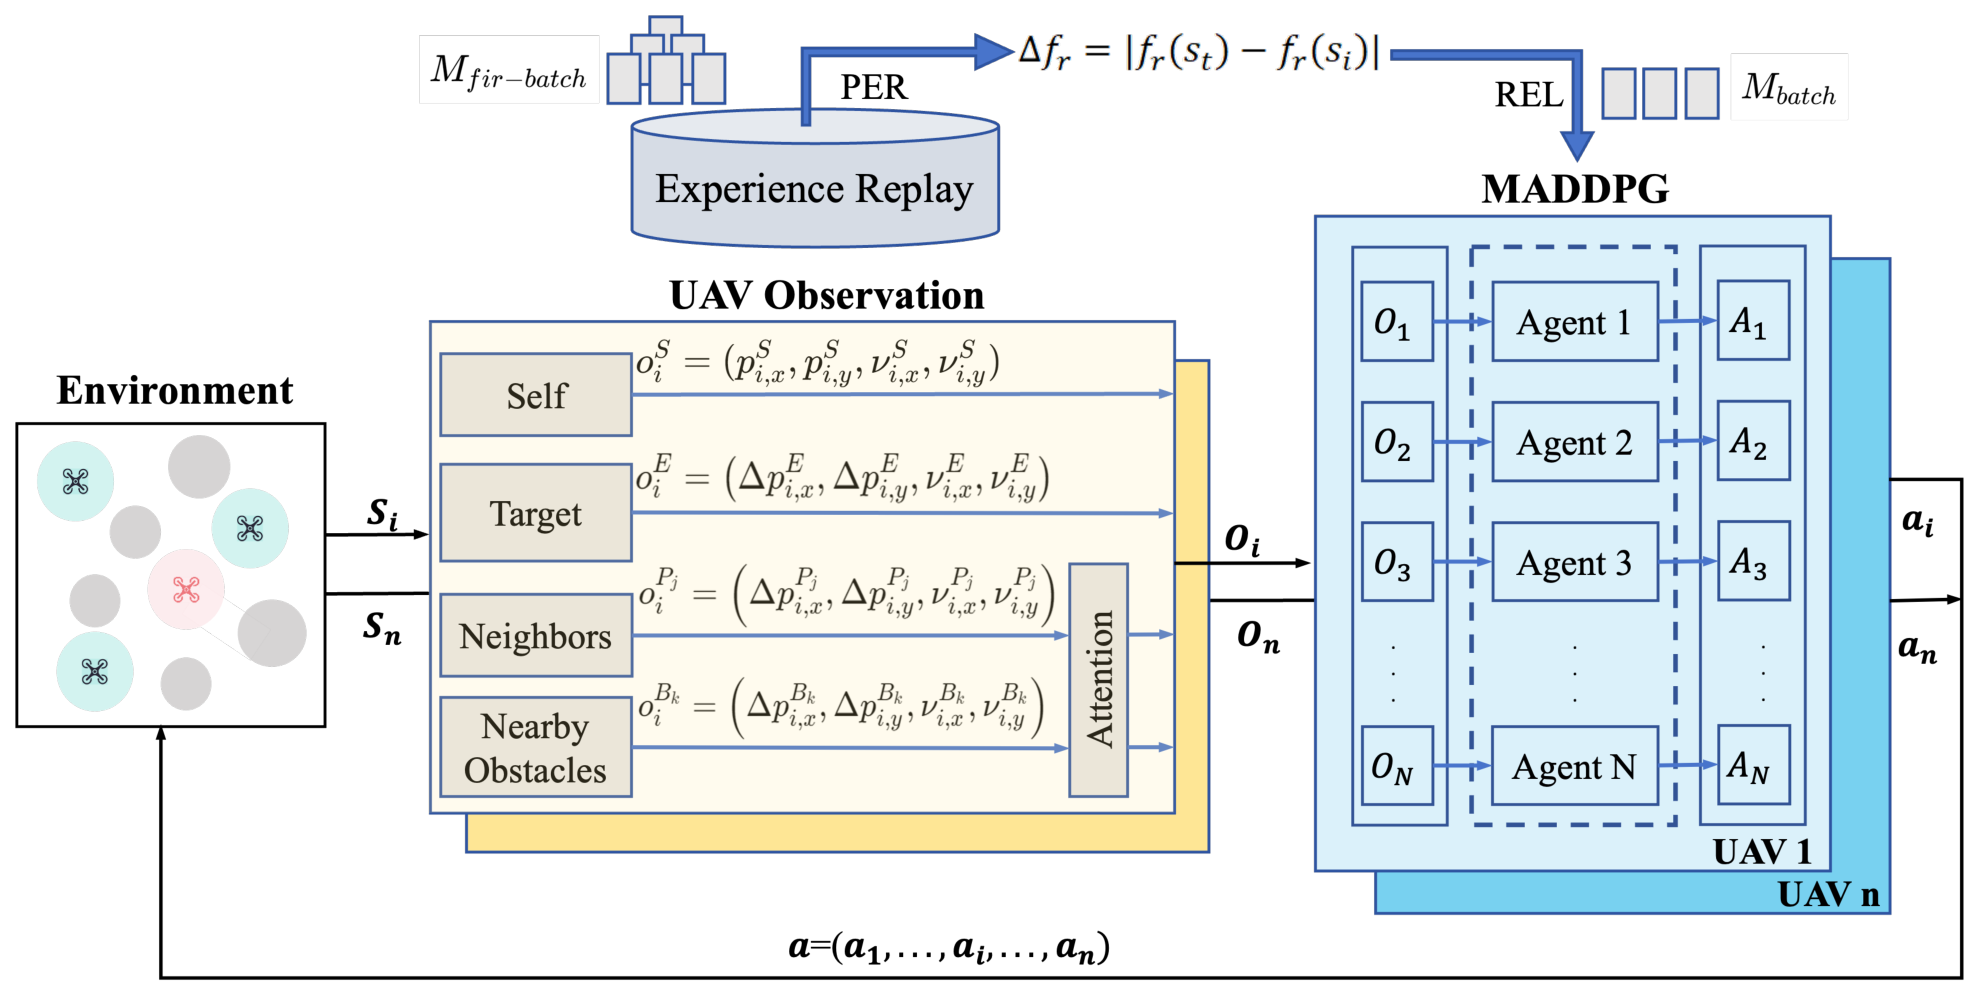
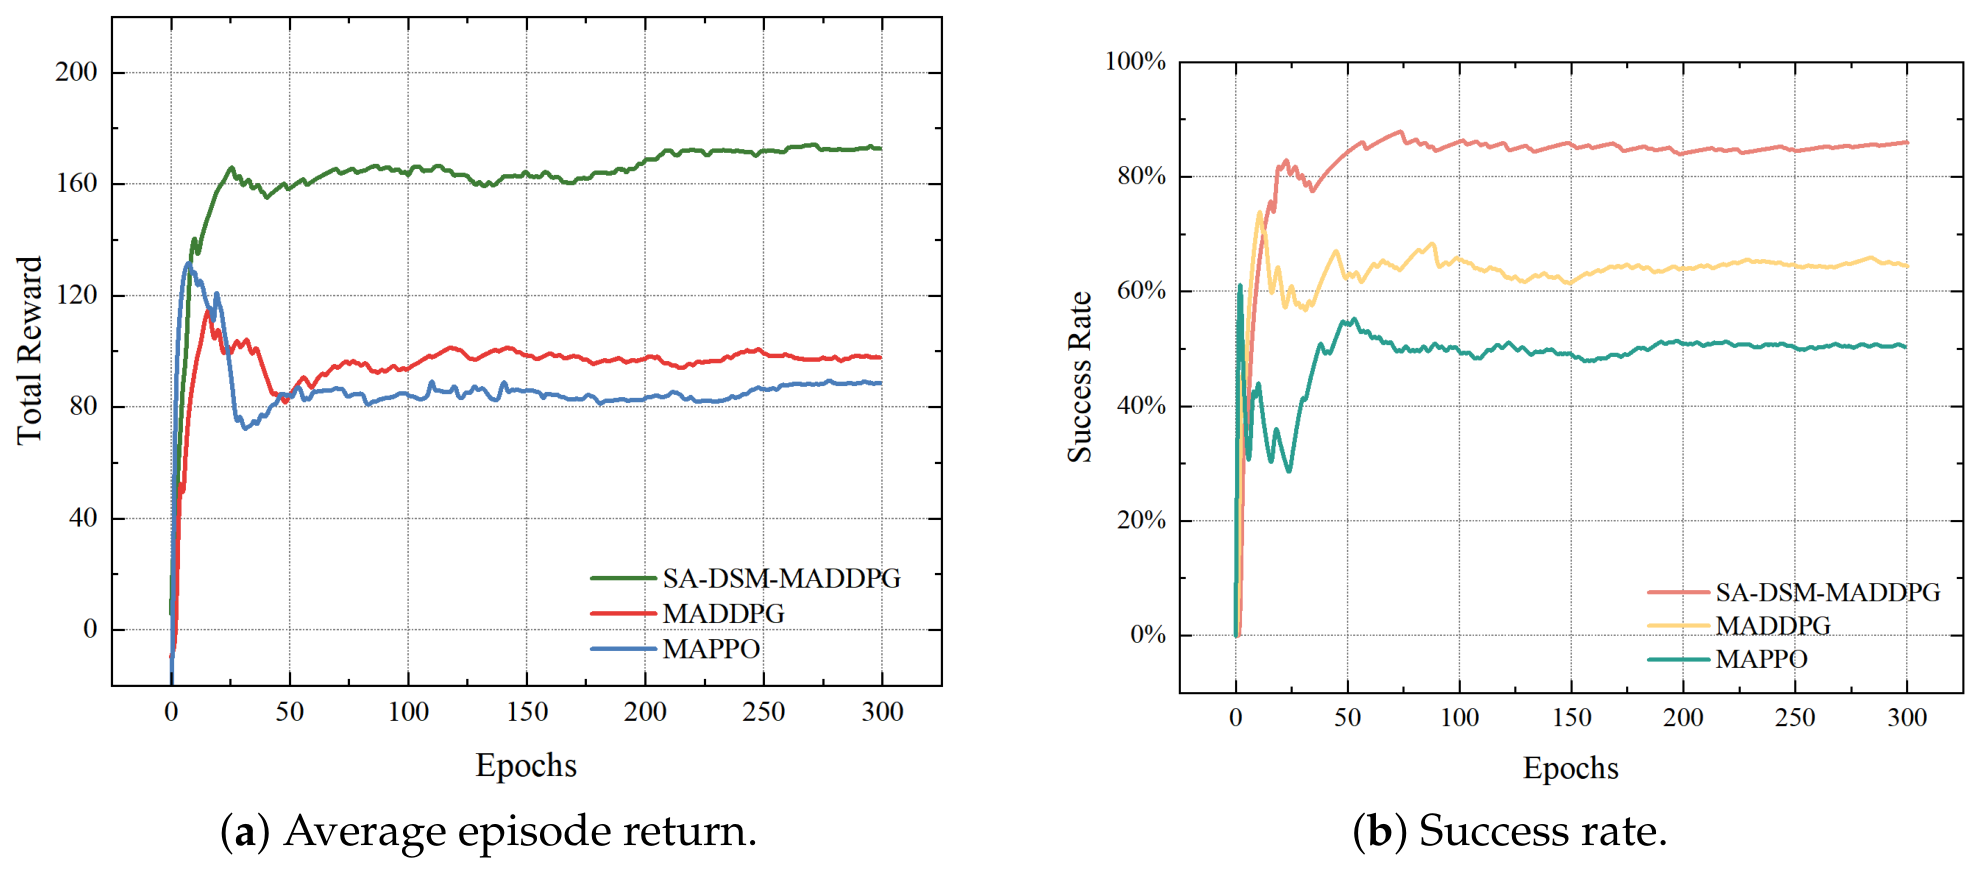
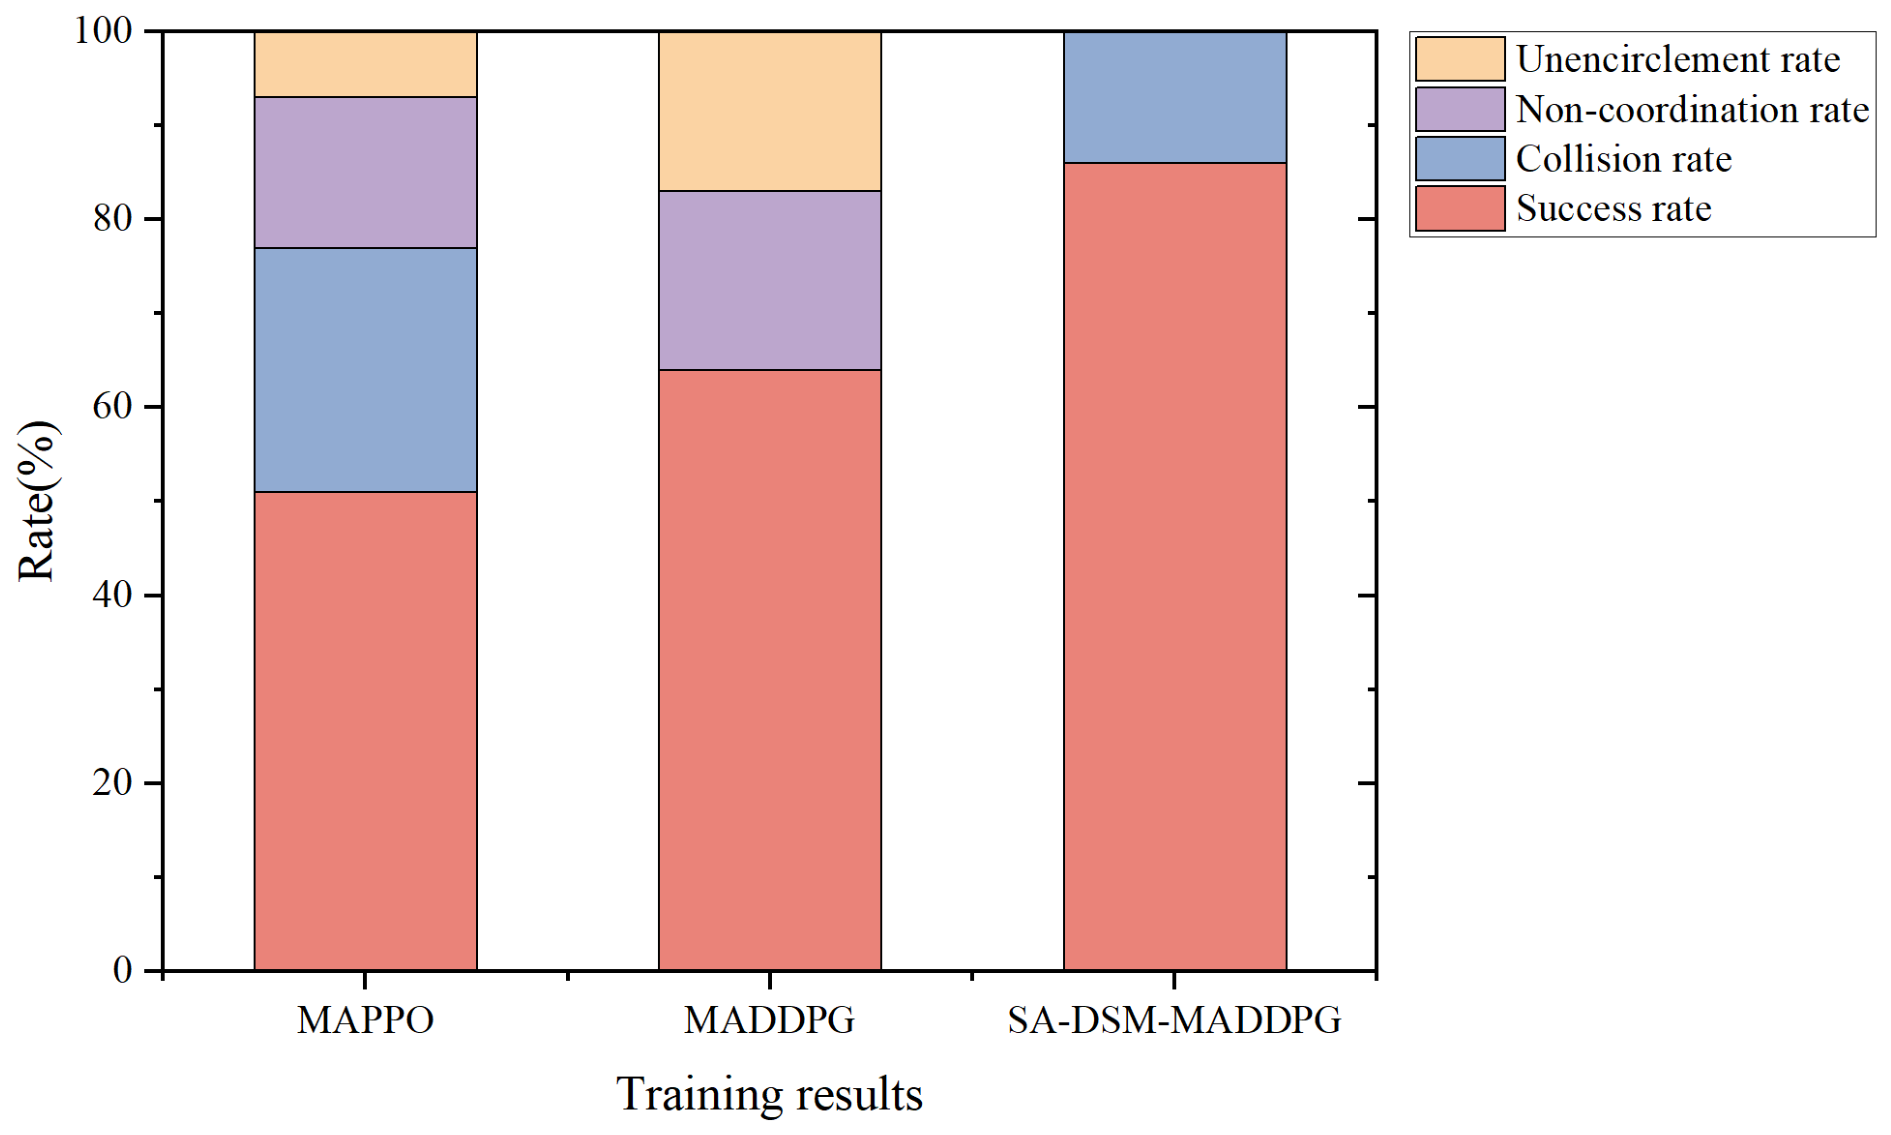
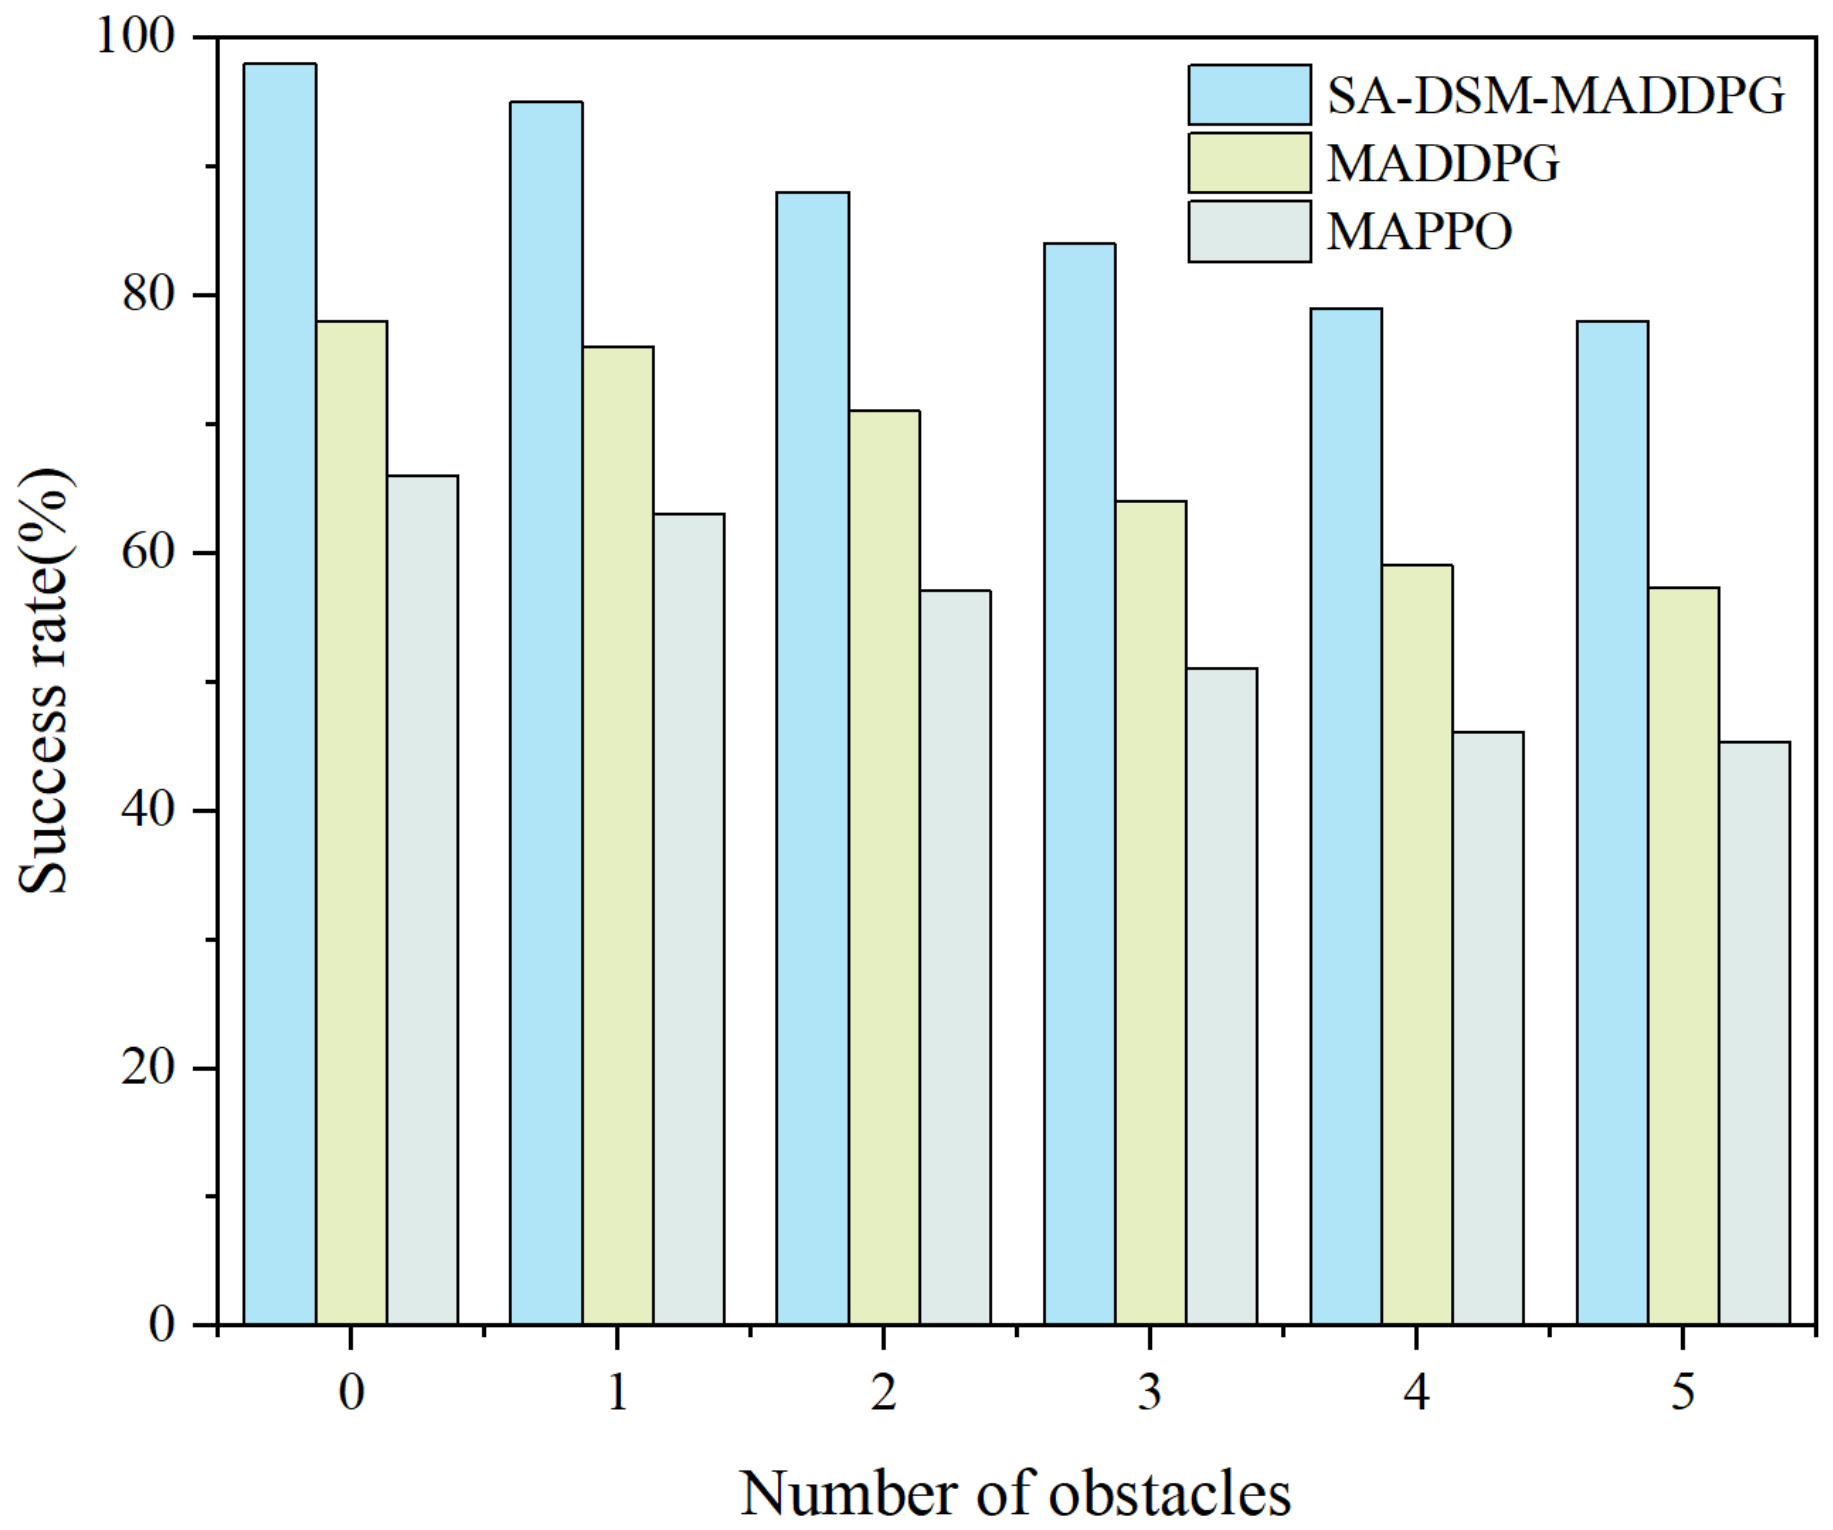
Multi-UAV cooperative encirclement in pursuit–evasion scenarios requires effective coordination under dynamic inter-agent interactions, sparse task feedback, and obstacle-constrained motion. While MADDPG offers a practical CTDE framework for multi-agent continuous control, its direct application to cooperative encirclement still faces challenges in modeling time-varying teammate dependencies, selecting informative replay samples, and maintaining stable learning under delayed rewards. To address these challenges, we propose SA-DSM-MADDPG, an enhanced multi-agent deep deterministic policy gradient method that integrates the following: (i) a self-attention critic to model dynamic inter-agent relevance, (ii) a double-screened experience replay strategy combining prioritized sampling and relevance screening to improve replay quality, and (iii) curriculum learning with staged reward shaping to provide denser and more stable training signals. We evaluate the proposed method in 3v1 cooperative encirclement environments with static obstacles and varying initial conditions. Experimental results show that SA-DSM-MADDPG improves the success rate by approximately 22 percentage points over MADDPG and 35 percentage points over MAPPO, while also exhibiting faster convergence and better training stability.
Keywords: multi-UAV; cooperative encirclement; multi-agent reinforcement learning (MARL); MADDPG; attention mechanism; experience replay; curriculum learning multi-UAV; cooperative encirclement; multi-agent reinforcement learning (MARL); MADDPG; attention mechanism; experience replay; curriculum learning